新智元报道
新智元报道

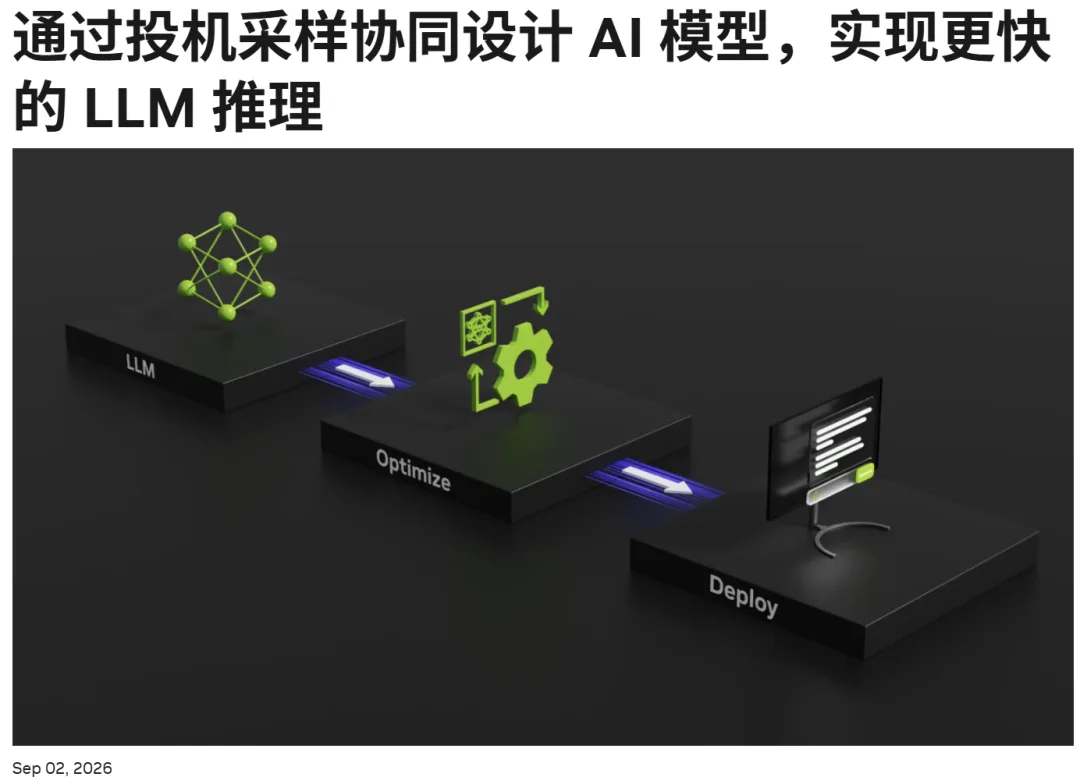
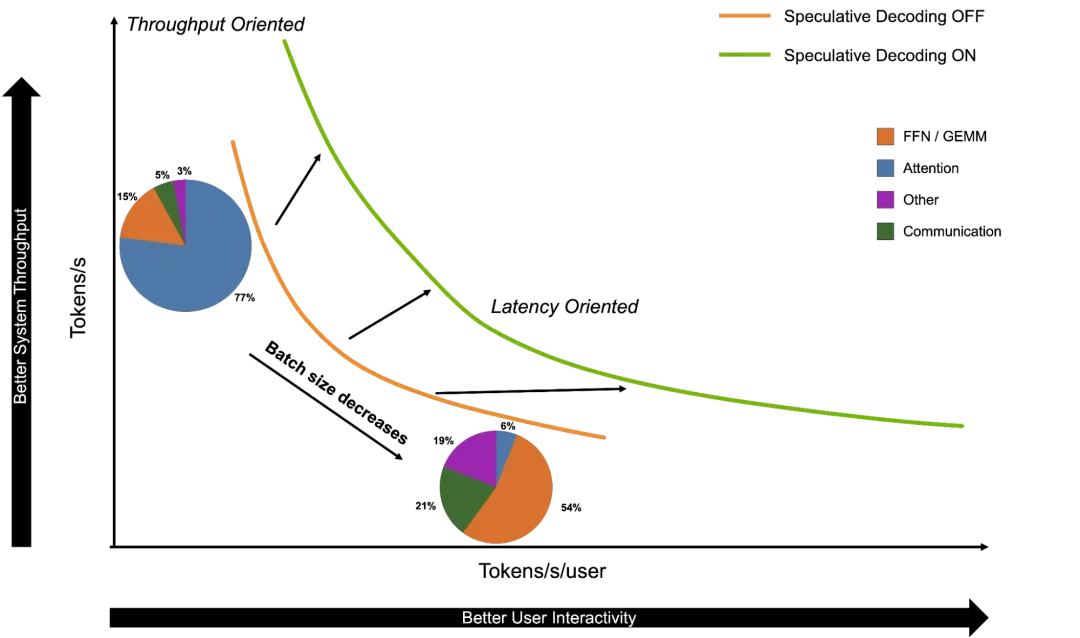
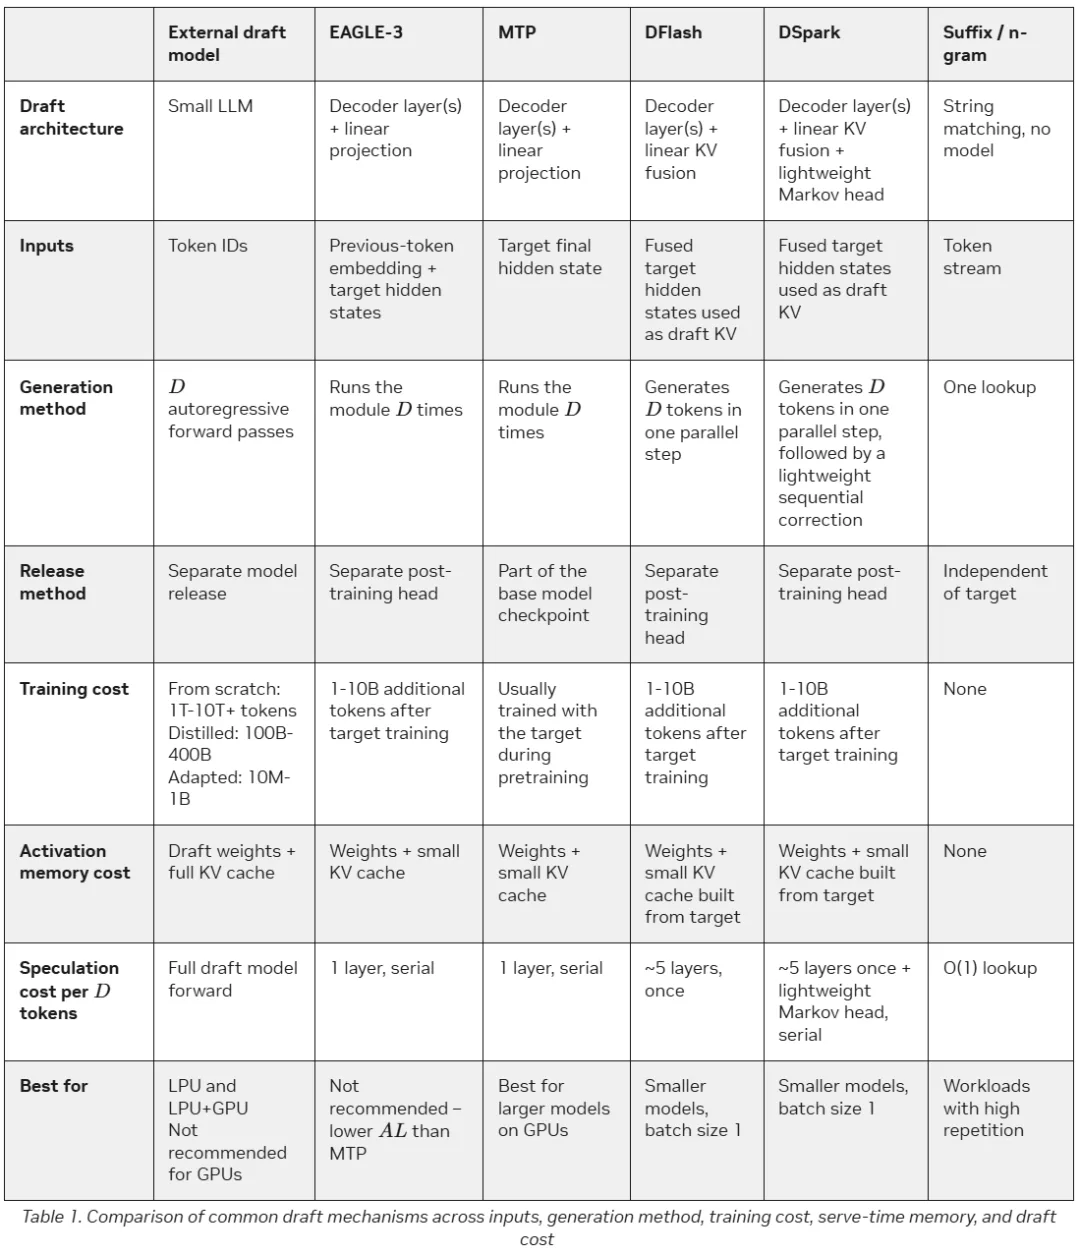
先找个轻量级的小模型做前置预测,一口气先猜7个字;然后大模型一次性对这7个字做验证。
验证7个字和自己写1个字的耗时差不多,毕竟权重反正都要搬一遍。
)。
× (1 + D) ≤ 128
参考资料:
https://developer.nvidia.com/blog/co-designing-ai-models-using-speculative-decoding-for-faster-llm-inference/
编辑:摩西
新智元报道
先找个轻量级的小模型做前置预测,一口气先猜7个字;然后大模型一次性对这7个字做验证。
验证7个字和自己写1个字的耗时差不多,毕竟权重反正都要搬一遍。
参考资料:
https://developer.nvidia.com/blog/co-designing-ai-models-using-speculative-decoding-for-faster-llm-inference/
编辑:摩西